LLM это большая языковая модель, та самая штука, которая отвечает вам в чате. LLM расшифровка простая: large language model, и за ними стоит устройство, объясняющее почти все странности, которые вы за ней замечали.
Двадцать минут на это устройство окупаются. Обычная офисная работа с генеративным ИИ идёт примерно на пятнадцать процентов быстрее, и выигрыш достаётся тем, кто понимает, с чем имеет дело, а не подбирает запросы наугад.
Разберём без схем и формул: чем LLM отличается от нейросети и от ИИ, что происходит внутри при каждом вашем сообщении и почему модель забывает начало разговора, выдумывает факты и по-разному отвечает на один и тот же вопрос.
Четыре слова, которые все путают
Начнём с терминов, потому что в текстах их валят в кучу. Вопрос «чем LLM отличается от AI» задают поисковику постоянно, и он справедливый.
- Искусственный интеллект значит тут больше всего. Под него попадает любая система, имитирующая человеческие способности: от шахматной программы до распознавания лиц. Конкретной технологии за ним не закреплено.
- Нейросеть называют одним из способов такую систему построить. Строят её по мотивам того, как связаны клетки мозга: заданный алгоритм такая программа не выполняет, зато выводит закономерности из примеров.
- Языковая модель это нейросеть, которую научили работать с текстом. Её задача звучит скучно: предсказать, какое слово вероятнее всего идёт следующим. Из этой скучной задачи и вырастает всё остальное.
LLM, большая языковая модель, отличается от предыдущей только размером. Слово «большая» тут про количество параметров и объём текстов, на которых её учили. Именно размер дал качественный скачок: маленькие языковые модели существовали годами и умели дописывать слово в поисковой строке, а большие внезапно начали писать связные тексты и рассуждать.
Генеративный ИИ добавим сюда пятым словом, потому что встречается оно всё чаще. Генеративный ИИ, он же генеративный искусственный интеллект в полной форме, это любая система, которая создаёт новое: текст, картинку, звук, видео. Ей противопоставляют системы, которые разбирают готовое: распознают лицо на снимке, находят брак на конвейере, предсказывают спрос по прошлым продажам.
Что такое генеративный ИИ через уже разобранные термины: это подмножество искусственного интеллекта, куда попадают и большие языковые модели, и генераторы картинок, и всё остальное, что выдаёт результат, которого раньше не было.
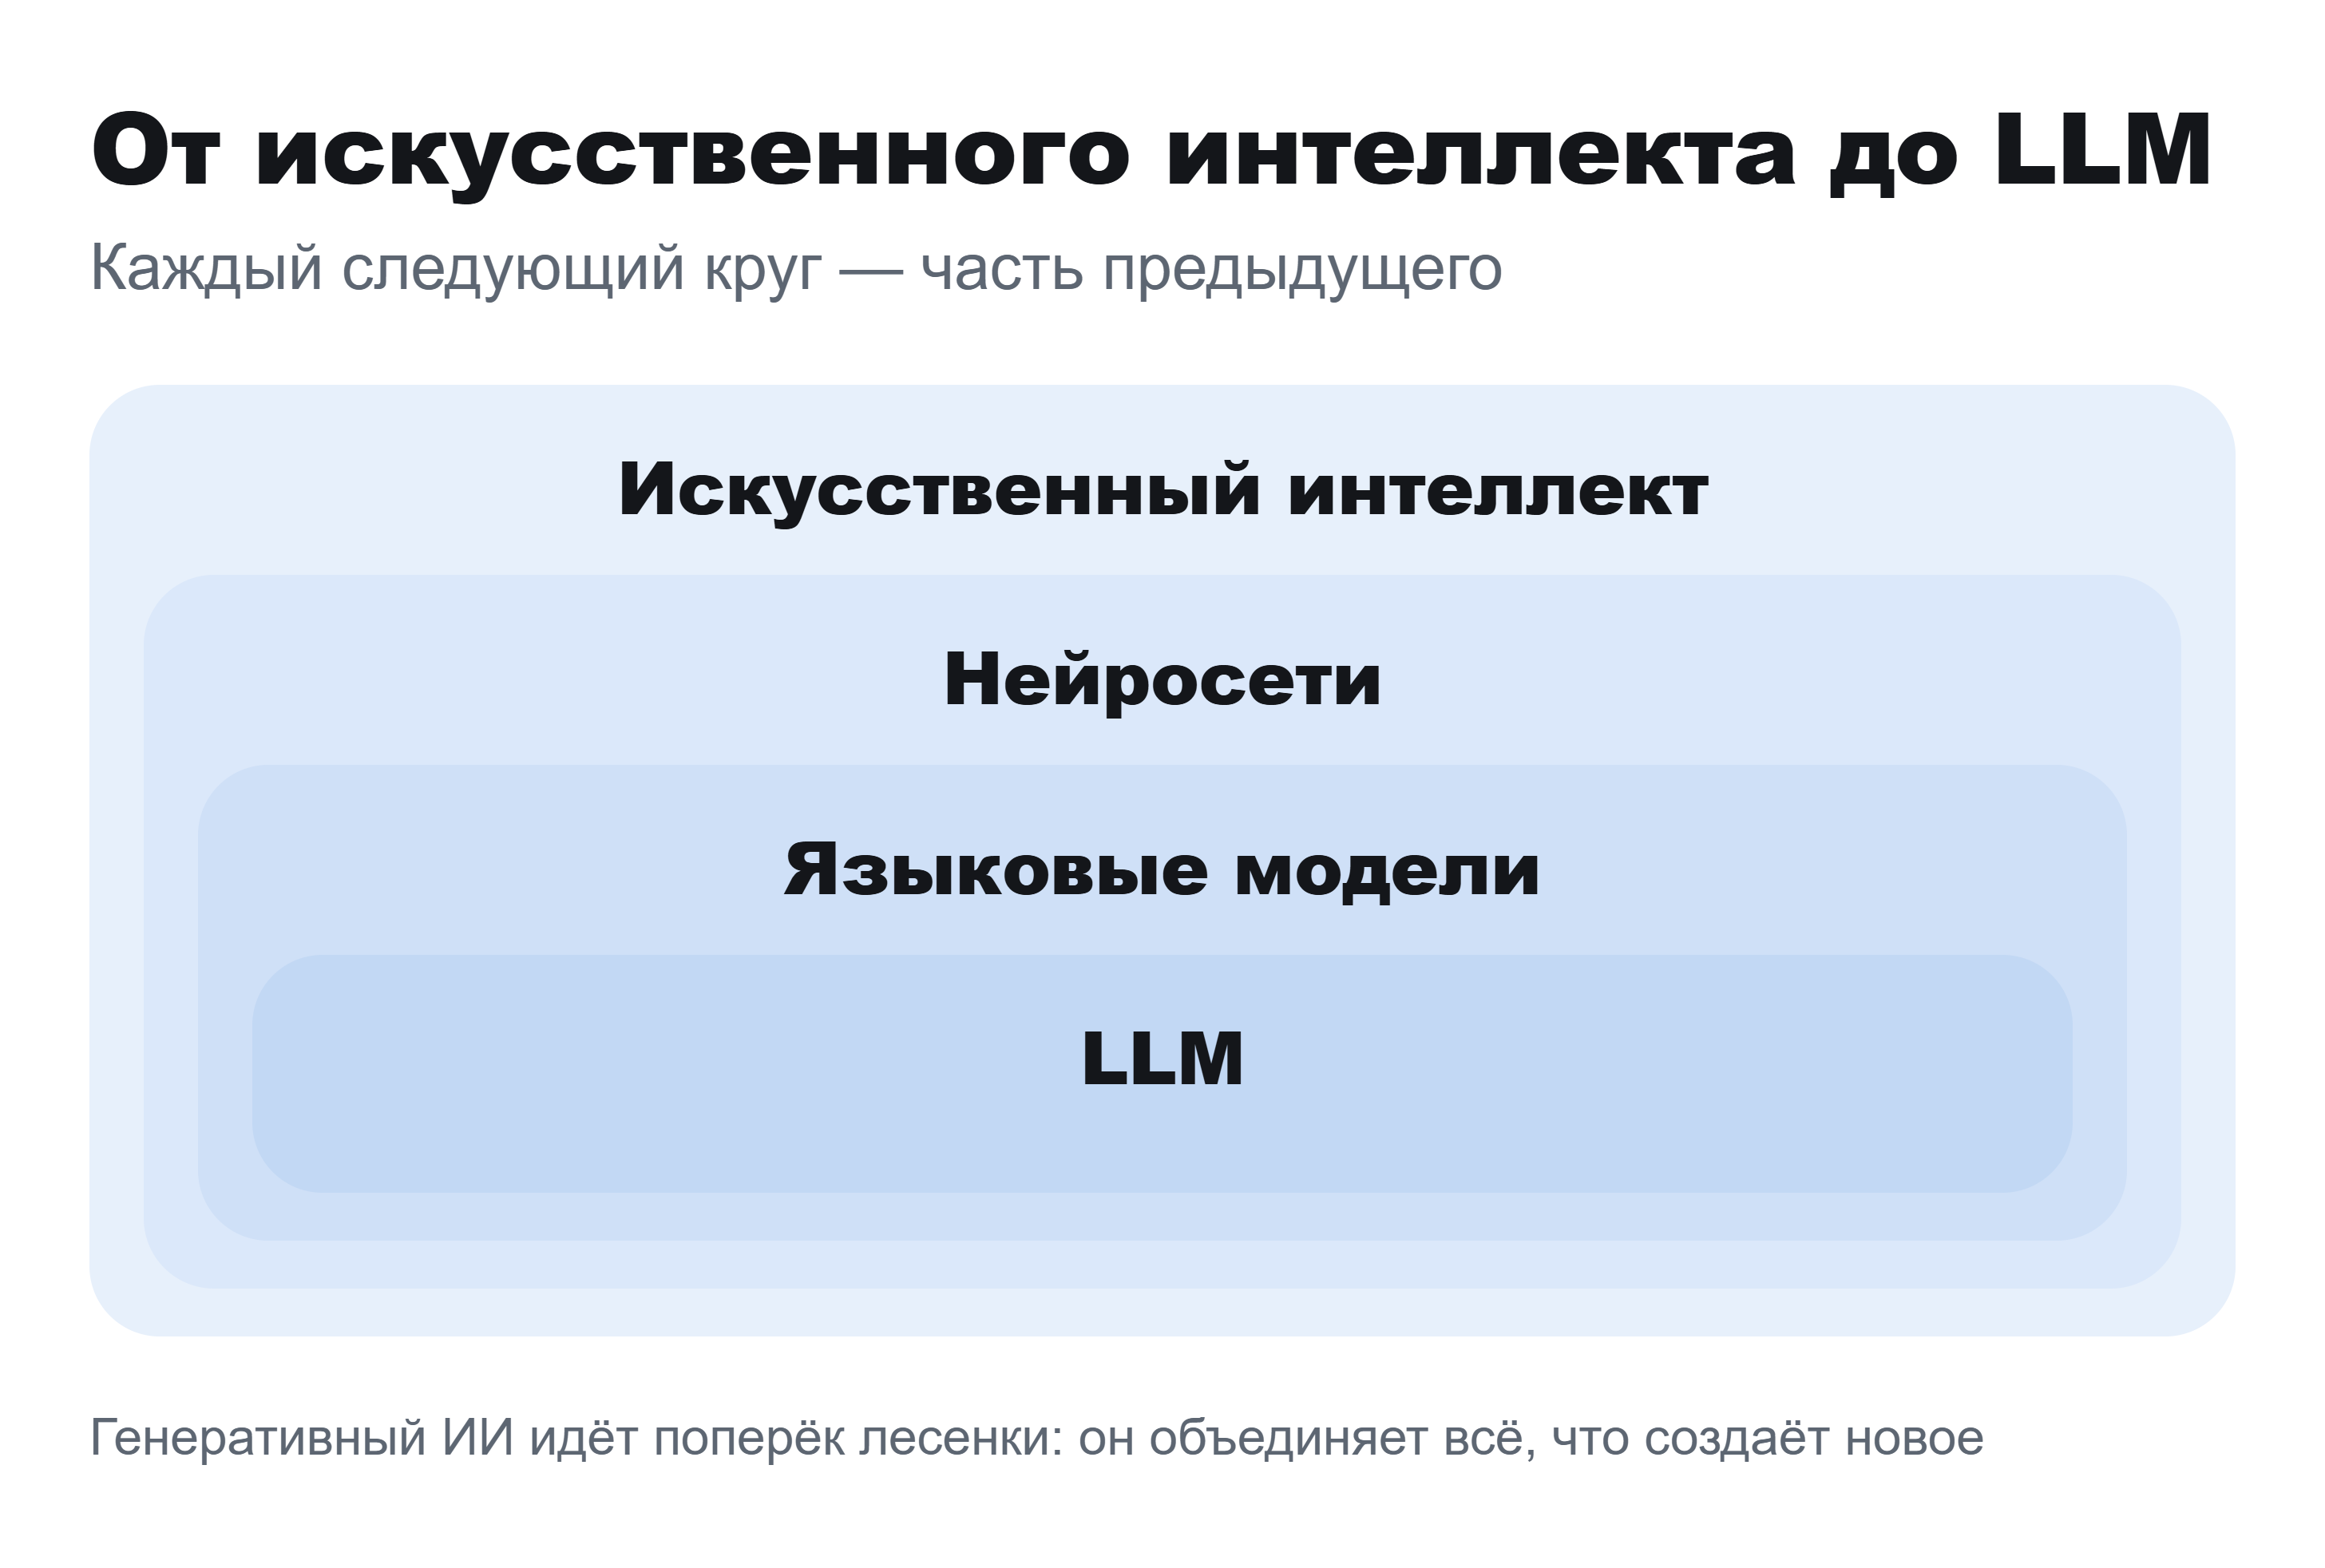
Вложенность получается такая. LLM входит в языковые модели, языковые модели входят в нейросети, нейросети входят в искусственный интеллект. Генеративный ИИ идёт поперёк этой лесенки: он объединяет всё, что создаёт новое, независимо от устройства. Когда в новости пишут «ИИ научился», почти всегда речь идёт про генеративный ИИ, а внутри него про LLM.
Что происходит внутри при каждом вашем сообщении
Механика проще, чем кажется, и знать её полезно ровно потому, что из неё следуют все странности.
Модель не хранит ответы и не ищет их в базе. Она предсказывает текст по одному кусочку за раз: смотрит на всё, что уже написано в разговоре, и выбирает наиболее вероятное продолжение. Потом смотрит снова, уже вместе с только что добавленным словом, и выбирает следующее, и так до конца ответа.
Представление о вероятном модель получила заранее. Её прогнали через гигантский объём текстов: книги, статьи, форумы, документацию, переписку. Из них она вывела закономерности: какие слова стоят рядом с какими, как строится аргумент, чем кончаются рецепты и как выглядит вежливый отказ. Никаких фактов в явном виде она не запомнила, только закономерности.
Отсюда следует главное. Модель не отличает правду от правдоподобного. Она выдаёт правдоподобное продолжение, и в большинстве случаев правдоподобное совпадает с правдивым, потому что в обучающих текстах правда встречалась чаще. Но совпадение это не гарантировано ничем.
Почему модель ведёт себя странно
Вот таблица, ради которой стоило читать предыдущий раздел. Слева свойство устройства, посередине то, что вы видите на экране, справа что с этим делать.
Контекстное окно конечно. За раз модель удерживает ограниченный объём текста: весь ваш разговор целиком плюс её собственные ответы. При переполнении начало вытесняет новый текст.
Вы это видите так: в длинном чате модель забывает, о чём вы договаривались в начале, теряет заданный тон, переспрашивает то, что вы уже говорили. Что делать: заводить новый чат под новую задачу и в начале каждого повторять главное, то есть роль, формат и ограничения.
Модель предсказывает вероятное. Проверкой она при этом не занимается, отсюда и выдуманные факты, которые звучат уверенно: несуществующие законы, ссылки на несуществующие статьи, придуманные цитаты.
Вы это видите так: ответ выглядит гладко и убедительно, а при проверке половина деталей не подтверждается. Что делать: проверять всё, что похоже на факт, особенно цифры, даты, имена и ссылки. Просить модель прямо сказать, когда она не уверена.
Обучение закончилось в какой-то момент. Свежие события до модели просто не дошли: они произошли после того, как её учили.
Вы это видите так: модель уверенно рассказывает про устаревшее положение дел. Что делать: давать свежий контекст самому, вставляя нужный текст прямо в запрос.
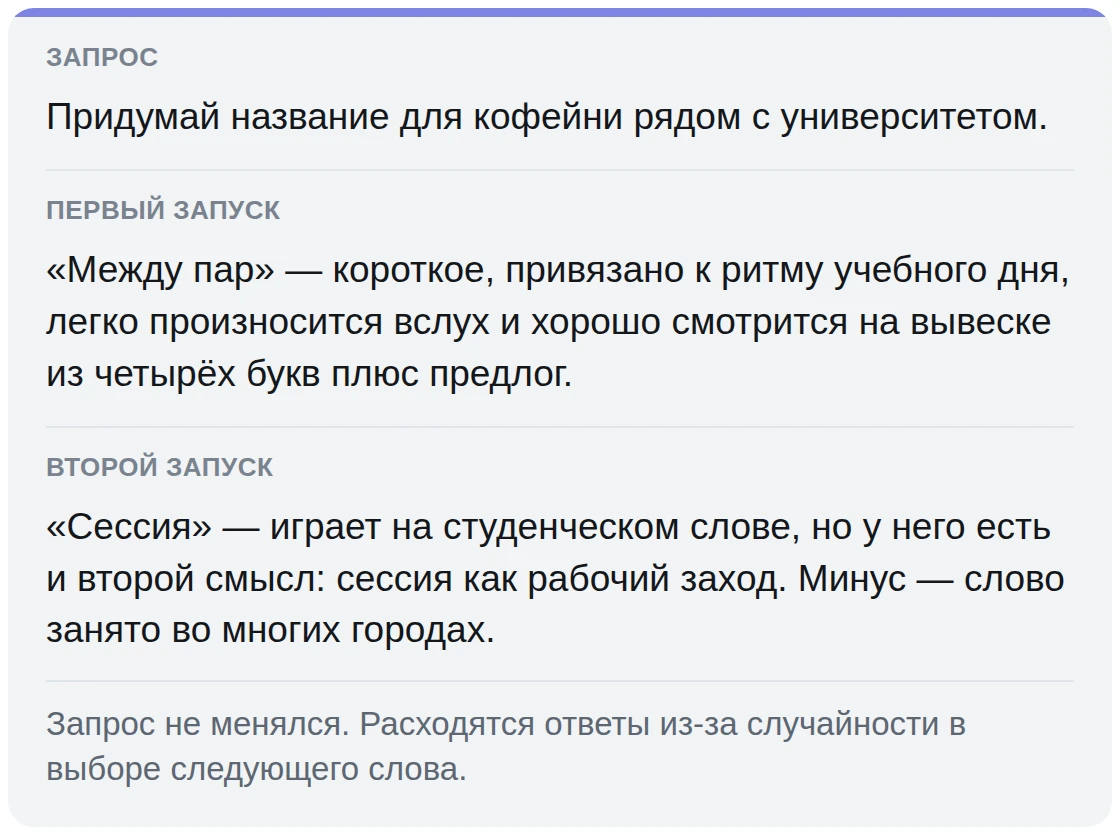
В выбор следующего слова заложена случайность. Самый вероятный вариант выбирается не каждый раз, иначе ответы выходили бы одинаковыми и скучными.
Вы это видите так: два одинаковых запроса дают разные ответы, иногда сильно разные по качеству. Что делать: переспрашивать и не считать первый ответ окончательным. Если он вышел слабым, тот же запрос со второй попытки нередко даёт результат заметно лучше.
Над вашим запросом стоит системный промпт. Сервис подставляет перед вашим сообщением собственную инструкцию, невидимую для вас: как себя вести, что обсуждать, чего избегать.
Вы это видите так: модель внезапно отказывается от безобидной просьбы, меняет тон или добавляет предупреждения, которых вы не просили. Что делать: помнить, что так распорядился сервис и к вам лично это отношения не имеет. Иногда хватает просто переформулировать задачу.
Задайте одной и той же модели один и тот же вопрос дважды в двух разных чатах и сравните ответы дословно. Разница покажет сразу два свойства из таблицы: и случайность выбора, и то, что предыдущий разговор нигде не хранится.
Содержание
Почему модель не умеет считать буквы
Отдельная странность, которая ставит людей в тупик. Спросите у чата, сколько букв «р» в слове «параграф», и он вполне может ошибиться. При этом сложную задачу на рассуждение та же модель решит без запинки.
Объяснение лежит в том, как текст попадает внутрь. Модель видит текст нарезанным на токены: куски длиной обычно в несколько символов. Ни букв, ни слов как отдельных единиц внутри нет. Слово может разбиться на два-три таких куска, а короткое слово целиком станет одним. Букв как отдельных единиц внутри просто нет.
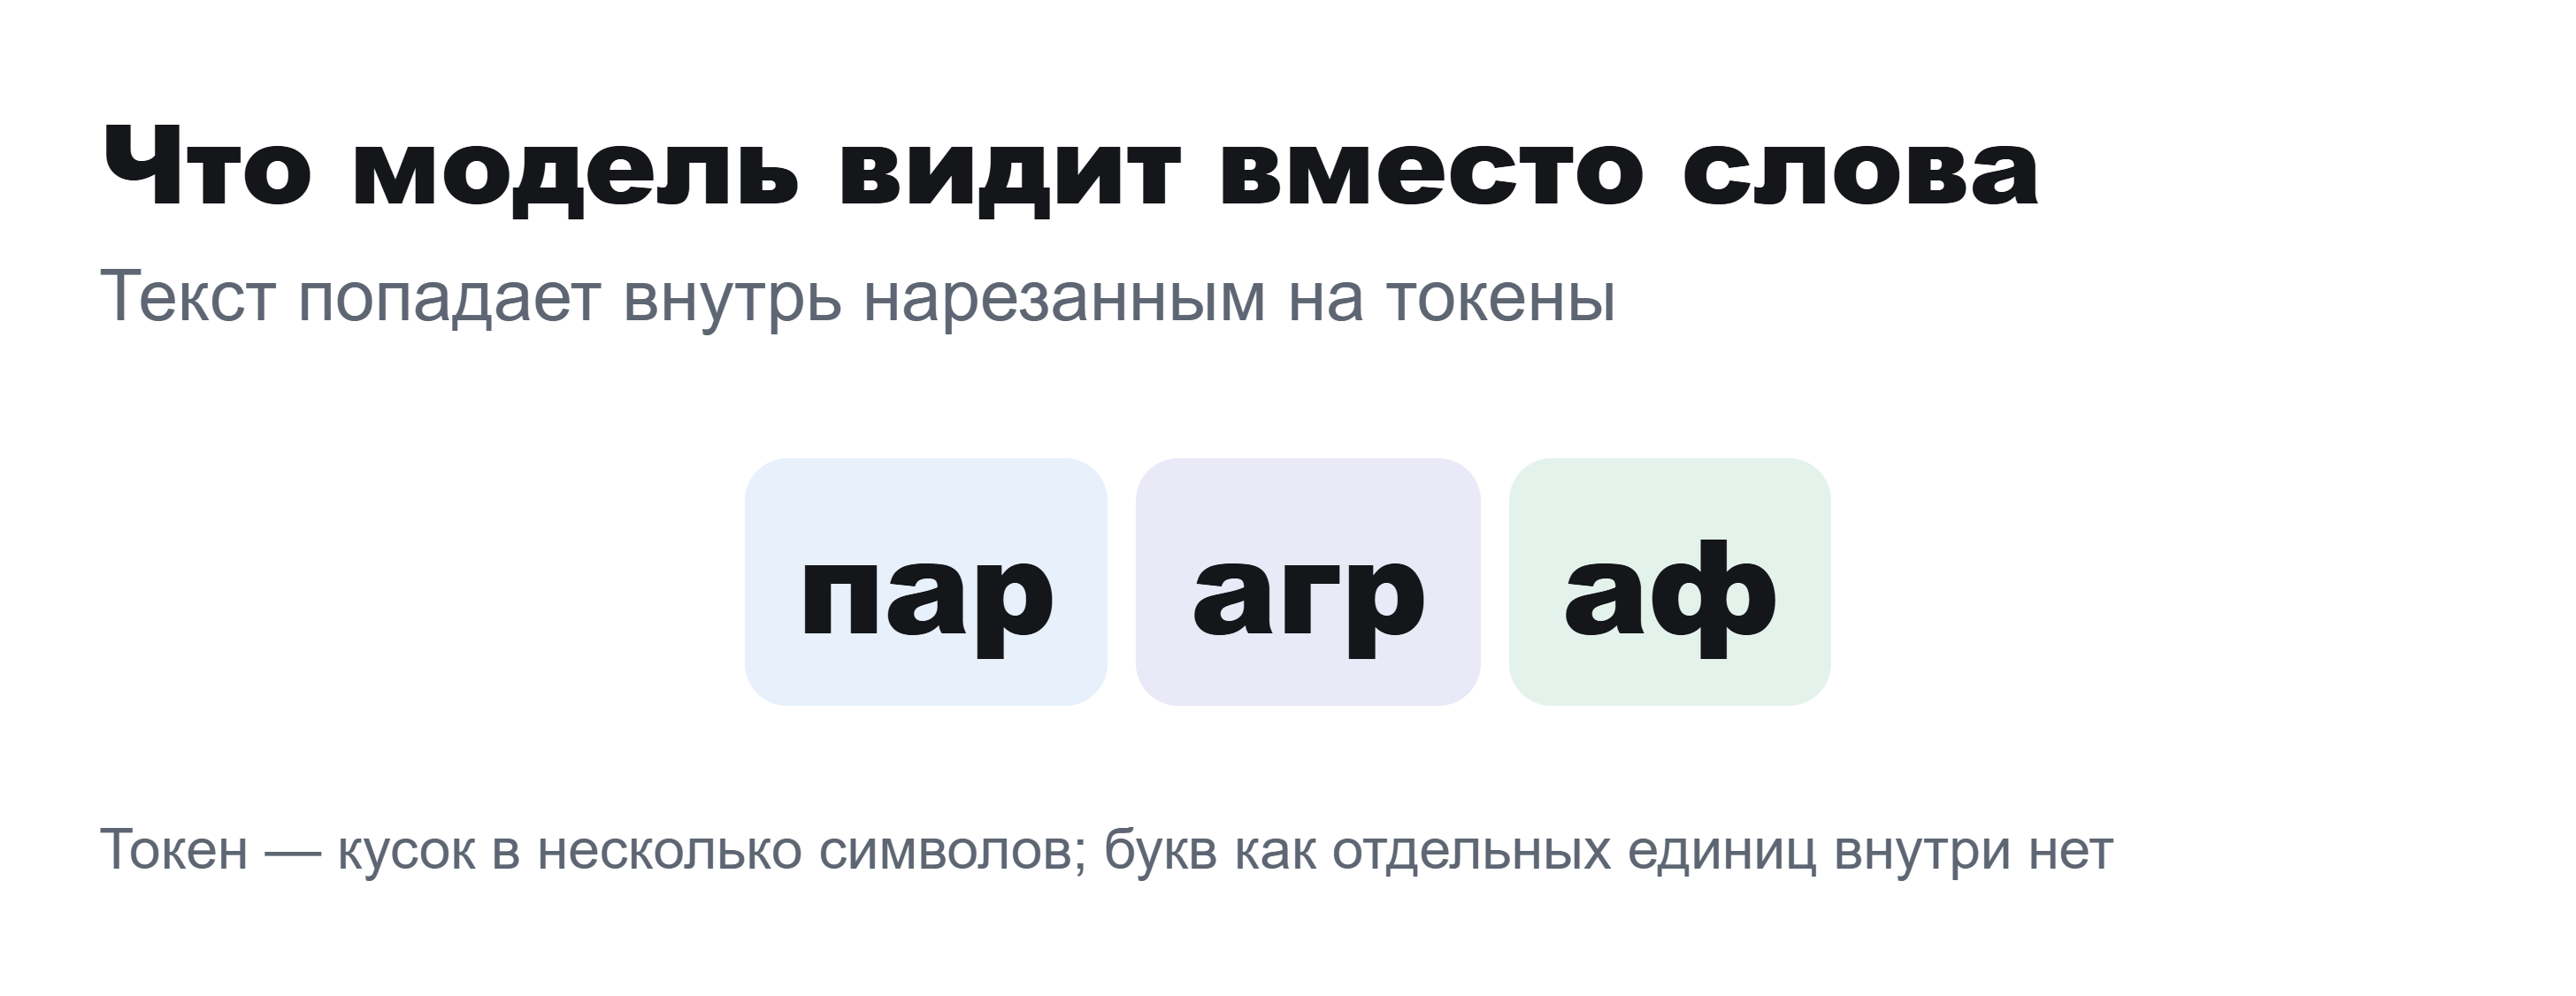
Отсюда и целое семейство мелких провалов: подсчёт символов, перевёртывание слова задом наперёд, поиск слов на заданную букву, работа с рифмой, точный подсчёт слов в тексте. Всё это требует разбирать текст на буквы, а модель до этого уровня не опускается.
Практический вывод простой. Задачи на точный подсчёт и на манипуляции с символами отдавайте обычным инструментам, от счётчика слов до формулы в таблице: чат тут только помешает. Держите в голове простое правило: модель хороша там, где нужен смысл, и слаба там, где нужна арифметика по знакам.
Что языковые модели делают хорошо, а что плохо
Свести всё сказанное можно к одной практической рамке. Механизм предсказания текста определяет и сильные стороны, и слабые, причём предсказуемо.
Работает хорошо:
- Работа с готовым текстом. Модель переформулирует, сократит, развернёт, переведёт и сменит тон в уже написанном. Тут модель в своей стихии: она перестраивает текст, а исходный смысл уже лежит перед ней в запросе.
- Перебор вариантов. Модель легко выдаст двадцать заголовков, десять названий или набор идей для рассылки. Правдоподобное продолжение тут ровно то, что нужно, и проверять фактуру не требуется.
- Разбор того, что вы дали. Модель выделит главное, составит структуру, найдёт противоречия и ответит на вопросы по документу. Материал лежит в контексте, придумывать нечего.
- Объяснения. Она разберёт понятие, распишет логику кода и перескажет сложное простыми словами. Тут работают закономерности из обучения, а объяснений в текстах модель видела очень много и в самых разных вариантах.
Работает плохо:
- Свежие и точные факты. Цифры, даты, цитаты, ссылки, положения закона и цены модель выдаёт с той же уверенностью, что и всё остальное, поэтому проверять их обязательно.
- Память за пределами разговора. Вас, ваши прошлые задачи и договорённости из позапрошлого чата модель не хранит.
- Точный подсчёт и работа с символами. Причину разобрали в предыдущем разделе.
- Ответственные решения. Медицинские, юридические и финансовые вопросы модель закроет уверенным ответом, но по тону отличить знание от догадки не выйдет.
Возьмите свою типичную рабочую задачу и определите, в какую половину списка она попадает. Если в первую половину, смело автоматизируйте. Если во вторую, берите модель как черновик, а проверку оставляйте за собой.
Как модель получает то, чего не знает
Из предыдущего раздела следует неудобное: модель не в курсе ваших документов, вашей переписки и вообще ничего, что не попало в обучение. Решают это двумя способами, и оба вы наверняка уже встречали.
- Подстановка прямо в запрос. Вы копируете нужный текст в чат и просите разобраться. Модель видит его в контексте разговора и работает с ним как с частью запроса. Способ простой и надёжный, но объём тут ограничен размером контекстного окна.
- RAG. Аббревиатура означает retrieval-augmented generation, то есть генерацию с подстановкой найденного. Идея та же, только текст ищется и подставляется автоматически.
По-человечески это выглядит так. Ваши документы заранее разрезают на куски и складывают в хранилище. Когда вы задаёте вопрос, система сначала находит там подходящие куски, потом подставляет их в запрос вместе с вашим вопросом, и уже это уходит модели. Модель отвечает так, будто нужный документ лежал перед ней с самого начала.
Из устройства следуют два практических вывода.
Ответ хорош ровно настолько, насколько хорош поиск. Если система вытащила не тот кусок, модель уверенно ответит по нему, и звучать это будет убедительно.
Отсутствие ответа в документах не мешает модели ответить. Она достроит недостающее по общим закономерностям, потому что это её основная работа. Проверять источники в таких системах нужно так же, как в обычном чате.
Как обучаются нейросети такого размера
Подробности тут читателю ни к чему, а вот общая картина пригодится.
Обучение идёт в два больших этапа.
- Сначала модель читает. Гигантский объём текстов пропускается через неё много раз, и она подстраивает внутренние числа-параметры так, чтобы всё лучше угадывать следующее слово. Никто не размечает эти тексты вручную и не объясняет модели, что правильно: она сама выводит закономерности из того, как люди пишут.
- Потом модель настраивают. На втором этапе люди показывают ей примеры хороших и плохих ответов, а иногда просто выбирают из двух вариантов лучший. Так её приучают отвечать полезно, вежливо и по делу, а простого правдоподобного продолжения становится мало.
Отсюда понятно, почему разные модели ведут себя по-разному при похожем устройстве. Первый этап у них похож, а вот второй у каждой свой: разные люди, разные инструкции, разные представления о том, что считать хорошим ответом.
И отсюда же понятно, почему модель нельзя «доучить» в разговоре. Ваша поправка действует в пределах текущего чата и в параметры не попадает. Закройте вкладку, и модель начнёт с чистого листа.
Частые вопросы
Коротко
LLM это большая языковая модель: нейросеть, которая по началу текста предсказывает продолжение. Вложенность терминов простая: LLM входит в языковые модели, те в нейросети, а нейросети в искусственный интеллект.
Из механизма предсказания следуют все странности, которые вы замечали. Начало длинного разговора теряется, потому что контекстное окно конечно. Выдумки звучат уверенно, потому что модель выдаёт правдоподобное. Свежих новостей в ответах нет, потому что обучение закончилось раньше. Повторный запрос даёт другой ответ, потому что в выбор заложена случайность. А внезапные отказы объясняет невидимая инструкция сервиса, которая стоит над вашим запросом.
Практический вывод из всего этого один. Проверяйте факты, начинайте новый чат под новую задачу, повторяйте важное в начале и не считайте первый ответ окончательным.
Понимание устройства даёт выгоду и за пределами удобства. По оценке PwC, работники с навыками в области ИИ получают премию к зарплате около 62 процентов против 57 процентов годом ранее - рынок платит за умение обращаться с этими инструментами, а умение начинается с понимания, как они устроены.